Qu'elle soit en ligne ou sur place, les formations en direct animées par un instructeur sur les GPU (Graphics Processing Unit) illustrent, à l'aide de discussions interactives et d'exercices pratiques, les fondamentaux des GPU et comment les programmer.
La formation sur les GPU est disponible en format « formation en direct en ligne » ou « formation en direct sur place ». La formation en direct en ligne (aussi appelée « formation en direct à distance ») se déroule au moyen d'un bureau à distance interactif. La formation en direct sur place peut être réalisée localement sur les installations du client à Ontario ou dans les centres de formation corporatives de NobleProg à Ontario.
NobleProg -- Votre fournisseur de formation local
London - London City Centre
380, rue Wellington, London, Canada, N6A 5B5
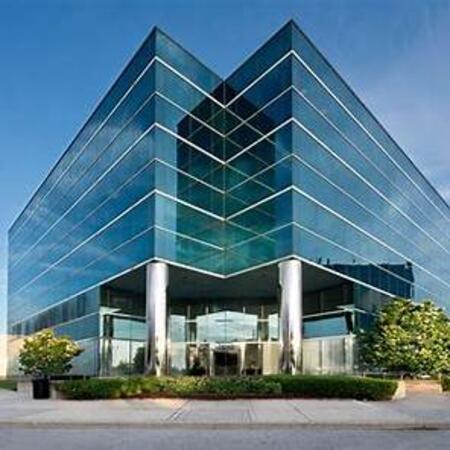
Le centre occupe le 6e étage du City Centre Building, un complexe d'angle idéalement situé au centre-ville de London, en Ontario.
West Toronto - Etobicoke
10 Four Seasons Place, Toronto, Canada, M9B 6H7
Etobicoke est un quartier prestigieux situé à l'ouest de Toronto, à mi-chemin entre Toronto et Mississauga. Facilement accessible par les transports en commun (bus) et à 5 minutes de la station de métro locale.
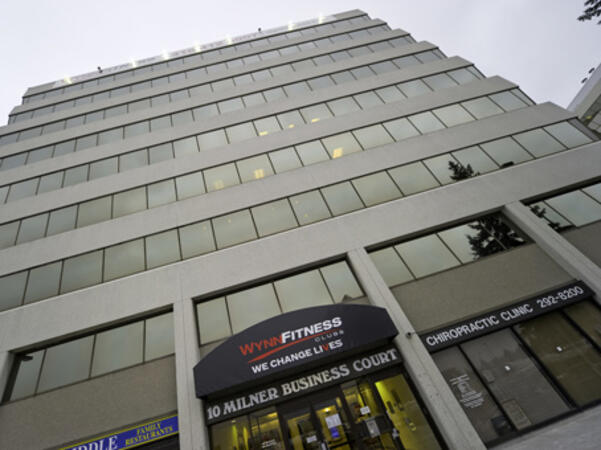
Scarborough – 10 Milner Business Court
10 Milner Business Court, Scarborough, Canada, M1B 3C6
Le Milner Court Centre occupe le troisième étage d'un immeuble d'angle. Il est facilement accessible par les transports en commun, que ce soit par autobus ou par le réseau de transport en commun rapide.
Oakville - Winston Park
2010, promenade Winston Park, Oakville, Canada, L6H 5R7
Le centre Winston Park est situé à proximité de la Queen Elizabeth Way et de l'Ontario 403, offrant un accès facile à Burlington et Hamilton à l'ouest et à Mississauga et Toronto à l'est.
Barrie - 49 High Street
49 rue High , Barrie, Canada, L4N 5J4
Équilibrez travail et loisirs dans nos bureaux situés au 49 High Street. Barrie possède un centre commercial animé et bénéficie d’une excellente connectivité – nos bureaux centraux se trouvent à seulement quelques minutes en voiture de l’autoroute 400
Maximisez les opportunités dans cette ville avant-gardiste, un centre de connaissances qui abrite plusieurs géants de la technologie. Notre centre bien desservi du 180 Northfield Drive West se trouve sur le campus d'entreprise de la ville, près de la prestigieuse Université de Waterloo.
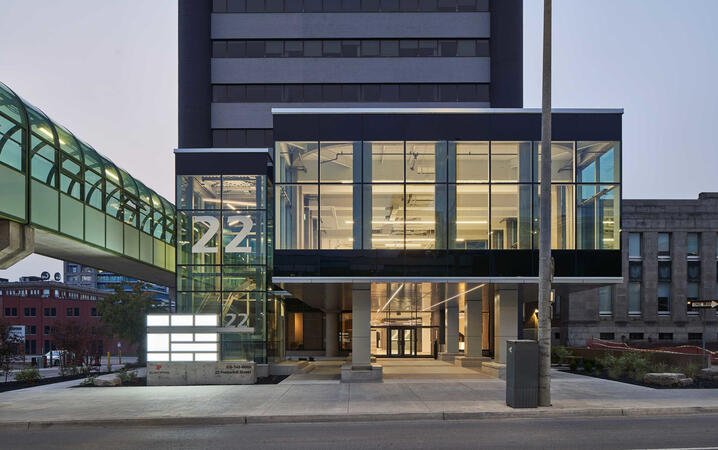
Kitchener - 22, rue Frederick
22, rue Frederick, Kitchener, canada, N2H 6M6
Espace de bureau de premier plan au centre-ville
Établissez votre entreprise au cœur du centre-ville de Kitchener. Travaillez aux côtés de sociétés financières et d'assurances de premier plan dans nos bureaux du 22 Frederick Street, au coin de Frederick Street, vous offrant un accès facile aux commodités locales.
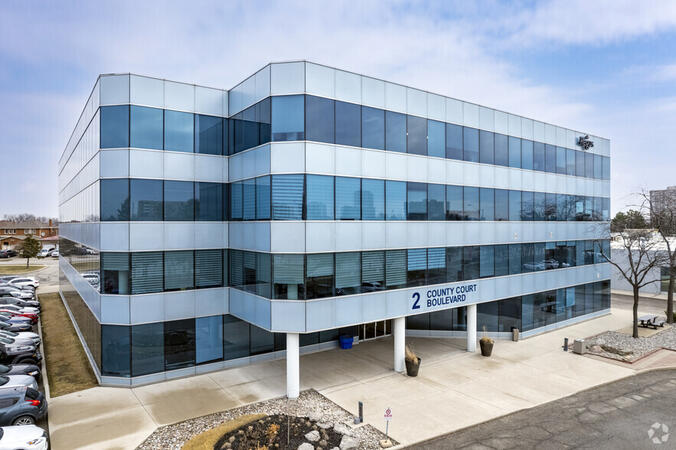
Brampton - 2 County Court
2 County Court Boulevard, Brampton, Canada, L6W 3W8
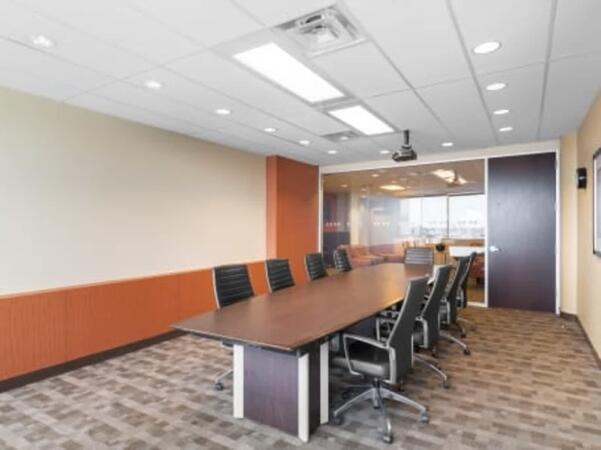
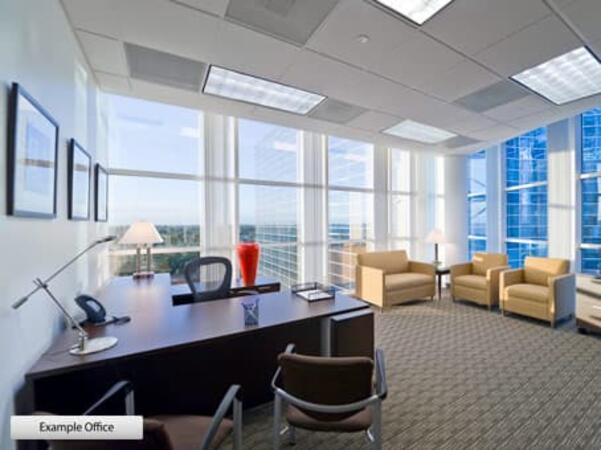
Tournez-vous vers l’avenir avec un espace de bureau au 2 County Court, un bâtiment aux performances environnementales exceptionnelles. La troisième plus grande ville du Grand Toronto bénéficie d’excellentes liaisons de transport, tandis que l’aéroport international de Toronto se trouve à moins de 16 km.
Richmond Hill - The Business Exchange
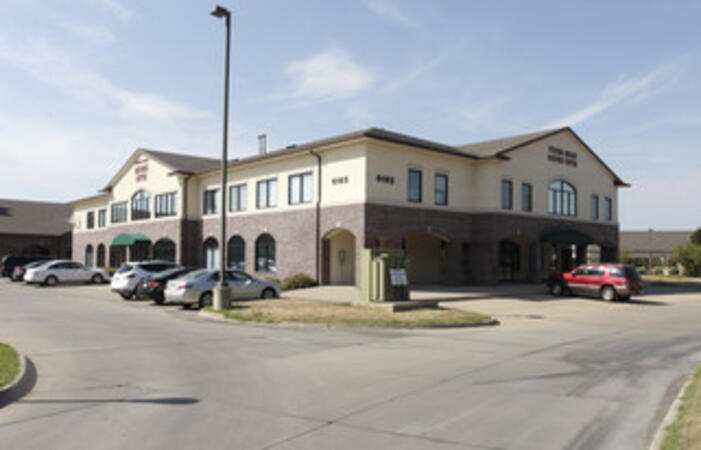
9225 Rue Leslie, Richmond Hill, Canada, L4B 3H6
Implantez votre entreprise dans le cadre paisible de Richmond Hill, qui abrite de grandes marques mondiales. Situé dans la banlieue nord, notre espace de travail The Business Exchange se trouve à seulement 30 minutes en voiture du centre de Toronto et de l'aéroport international.
Ottawa - Albert & Metcalfe
116, rue Albert, Ottawa, Canada, K1P 5G3
En face du World Exchange Plaza. Le Centre Shaw d'Ottawa et le centre commercial CF Rideau Centre sont à 10 minutes.
Barrie-49 Rue High
3ᵉ étage, Rue Dunlop Ouest, Barrie, Canada, L4N 1A8
Un Parfait Équilibre entre Travail et Loisirs au Bord du Lac Simcoe
Alliez productivité et détente dans notre espace de bureau situé au 49 High Street. Situé au cœur du centre commercial animé de Barrie, cet espace de travail bénéficie d'une excellente connectivité, avec l'autoroute 400 à quelques minutes en voiture.
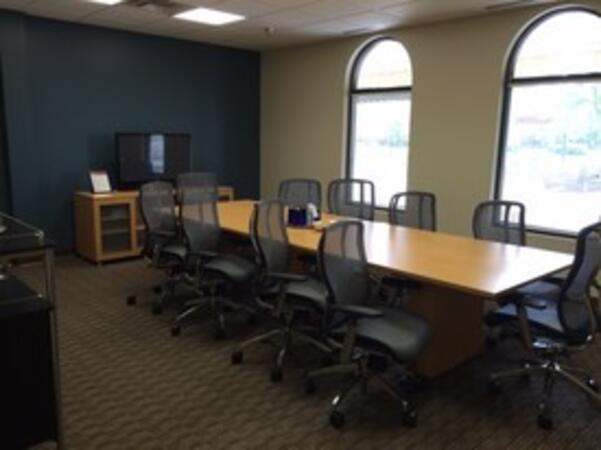
Travaillez efficacement dans un bâtiment en brique moderne avec une entrée vitrée, des espaces de travail magnifiquement conçus et des œuvres d'art dans toutes les salles de réunion. Après une journée productive, profitez des nombreux restaurants à proximité ou faites une promenade agréable jusqu'à Heritage Park en bord de mer pour vous détendre.
Toronto - Rue Toronto
36, rue Toronto, Toronto, Canada, M5C 2C5
À quelques pas du prestigieux centre financier de Toronto. Liaison rapide vers l'aéroport international Pearson - à moins de 30 minutes.
Ottawa - 343 Preston
343, rue Preston, Ottawa, Canada, K1S 1N4
Au dernier étage d'une tour de bureaux distinctive, bien visible depuis l'autoroute 417, vous trouverez le Regus 343 Preston Centre à Ottawa. À seulement 10 minutes en voiture du centre-ville d'Ottawa, à quelques pas du lac Downs et à proximité de l'intersection animée de Preston Gladstone dans la Petite Italie.
Mississauga - Airways
5925, chemin de l'Aéroport, Mississauga, Canada, L4V 1W1
Airways est un magnifique centre situé au 5925 Airport Road, juste en face de l'aéroport international Pearson de Toronto, qui propose des services de navette. Adjacent aux autoroutes 409 et 427, notre centre est facilement accessible.
Cette formation en direct, animée par un formateur, dans Ontario, guide les ingénieurs IA de niveau intermédiaire pour construire et optimiser des modèles de réseaux de neurones à l'aide de la plateforme Huawei Ascend et du kit d'outils CANN. Les participants configureront des environnements, développeront des applications avec MindSpore et déploieront dans des configurations de périphérie ou de nuage.
Cette formation en direct animée par un formateur dans le domaine Ontario explore la pile IA de Huawei, du SDK CANN au cadre MindSpore. Elle aide les débutants et les professionnels intermédiaires à comprendre comment ces composants s'intègrent sur le matériel Ascend pour la gestion du cycle de vie et le déploiement.
Cette formation en direct animée par un instructeur en <lieu> (en ligne ou en présentiel) s'adresse aux développeurs de niveau débutant à intermédiaire qui souhaitent utiliser OpenACC pour programmer des appareils hétérogènes et exploiter leur parallélisme.
À la fin de cette formation, les participants seront capables de :
Configurer un environnement de développement OpenACC.
Écrire et exécuter un programme OpenACC de base.
Annoter le code avec des directives et des clauses OpenACC.
Utiliser l'API et les bibliothèques OpenACC.
Profiling, déboguer et optimiser les programmes OpenACC.
Cette formation en direct avec instructeur Ontario couvre le déploiement et l'optimisation des modèles CV et TALN à l'aide du CANN SDK pour le matériel Ascend. Les participants apprendront à convertir les modèles, à les intégrer dans des pipelines en direct et à améliorer les performances de déduction pour une détection et une analyse en temps réel.
Cette formation en direct, animée par un formateur, en <lieu> (en ligne ou en présentiel), s'adresse aux développeurs de niveau débutant à intermédiaire souhaitant apprendre les bases de la programmation GPU ainsi que les principaux frameworks et outils pour le développement d'applications GPU.
À l'issue de cette formation, les participants seront en mesure de : Comprendre la différence entre le calcul CPU et GPU, ainsi que les avantages et les défis de la programmation GPU.
Choisir le framework et l'outil adaptés à leur application GPU.
Créer un programme GPU de base effectuant une addition de vecteurs en utilisant un ou plusieurs des frameworks et outils.
Utiliser les API, langages et bibliothèques respectifs pour interroger les informations de l'appareil, allouer et libérer la mémoire de l'appareil, copier des données entre l'hôte et l'appareil, lancer des noyaux et synchroniser les threads.
Utiliser les espaces mémoire respectifs, tels que global, local, constant et privé, pour optimiser les transferts de données et les accès mémoire.
Utiliser les modèles d'exécution respectifs, tels que les work-items, les work-groups, les threads, les blocs et les grilles, pour contrôler le parallélisme.
Débugger et tester des programmes GPU à l'aide d'outils tels que CodeXL, CUDA-GDB, CUDA-MEMCHECK et NVIDIA Nsight.
Optimiser les programmes GPU à l'aide de techniques telles que le regroupement (coalescing), la mise en cache, la pré-extraction (prefetching) et le profilage.
Cette formation en direct, animée par un formateur dans Ontario, permet aux développeurs avancés d'acquérir les compétences nécessaires pour concevoir, déployer et affiner des opérateurs IA personnalisés. Les participants maîtriseront l'intégration de CANN TIK et d'Apache TVM, permettant une optimisation avancée et un ordonnancement sur le matériel Huawei Ascend pour des performances réelles.
Cette formation en direct, animée par un formateur à Ontario (en ligne ou sur site), s'adresse aux développeurs de niveau débutant à intermédiaire qui souhaitent utiliser différents frameworks pour la programmation GPU et comparer leurs fonctionnalités, performances et compatibilité.
À l'issue de cette formation, les participants seront en mesure de :
Configurer un environnement de développement incluant le SDK OpenCL, le kit d'outils CUDA, la plateforme ROCm, un appareil prenant en charge OpenCL, CUDA ou ROCm, et Visual Studio Code.
Créer un programme GPU de base effectuant une addition de vecteurs à l'aide d'OpenCL, CUDA et ROCm, et comparer la syntaxe, la structure et l'exécution de chaque framework.
Utiliser les API respectives pour interroger les informations sur les appareils, allouer et libérer la mémoire de l'appareil, copier des données entre l'hôte et l'appareil, lancer des noyaux et synchroniser les threads.
Utiliser les langages respectifs pour écrire des noyaux qui s'exécutent sur l'appareil et manipulent des données.
Utiliser les fonctions intégrées, variables et bibliothèques respectives pour effectuer des tâches et opérations courantes.
Utiliser les espaces mémoire respectifs, tels que global, local, constant et privé, pour optimiser les transferts de données et les accès mémoire.
Utiliser les modèles d'exécution respectifs pour contrôler les threads, les blocs et les grilles qui définissent le parallélisme.
Déboguer et tester les programmes GPU à l'aide d'outils tels que CodeXL, CUDA-GDB, CUDA-MEMCHECK et NVIDIA Nsight.
Optimiser les programmes GPU en utilisant des techniques telles que le regroupement (coalescing), la mise en cache, la pré-fetching et le profilage.
Cette formation encadrée par un formateur dans Ontario présente CloudMatrix pour l'inférence d'IA évolutive. Apprenez à déployer, optimiser et surveiller des modèles en utilisant CANN et MindSpore. Des exercices pratiques couvrent l'emballage, la conversion, la fourniture de services et l'optimisation des performances pour les charges de travail en temps réel et par lots.
Cette formation en direct, animée par un formateur à Ontario, couvre les concepts fondamentaux et les bases pratiques du déploiement de modèles IA sur des appareils de périphérie Ascend à l'aide de la boîte à outils CANN, permettant aux participants de développer des compétences pratiques en matière de compilation, d'optimisation et de gestion d'environnements contraints.
Cette formation en direct animée par un instructeur en Ontario (en ligne ou sur site) s'adresse aux développeurs de niveau débutant à intermédiaire qui souhaitent installer et utiliser ROCm sur Windows pour programmer des GPU AMD et exploiter leur parallélisme.
À la fin de cette formation, les participants seront capables de :
Mettre en place un environnement de développement incluant la plate-forme ROCm, un GPU AMD et Visual Studio Code sous Windows.
Créer un programme ROCm de base effectuant une addition de vecteurs sur le GPU et récupérant les résultats de la mémoire du GPU.
Utiliser l'API ROCm pour interroger les informations du dispositif, allouer et libérer de la mémoire de dispositif, copier des données entre l'hôte et le dispositif, lancer des noyaux (kernels) et synchroniser les threads.
Utiliser le langage HIP pour écrire des noyaux qui s'exécutent sur le GPU et manipulent les données.
Utiliser les fonctions intégrées, les variables et les bibliothèques HIP pour effectuer des tâches et opérations courantes.
Utiliser les espaces mémoire ROCm et HIP, tels que global, partagé, constant et local, pour optimiser les transferts de données et les accès mémoire.
Utiliser les modèles d'exécution ROCm et HIP pour contrôler les threads, les blocs et les grilles qui définissent le parallélisme.
Déboguer et tester les programmes ROCm et HIP à l'aide d'outils tels que ROCm Debugger et ROCm Profiler.
Optimiser les programmes ROCm et HIP en utilisant des techniques telles que la concaténation (coalescing), la mise en cache, la prérecherche (prefetching) et le profilage.
Cette formation en direct, encadrée par un instructeur, en <lieu> (en ligne ou sur site), s'adresse aux développeurs de niveau débutant à intermédiaire qui souhaitent utiliser ROCm et HIP pour programmer les GPU AMD et exploiter leur parallélisme.
À la fin de cette formation, les participants seront capables de :
Mettre en place un environnement de développement comprenant la plateforme ROCm, un GPU AMD et Visual Studio Code.
Créer un programme ROCm basique effectuant une addition vectorielle sur le GPU et récupérant les résultats depuis la mémoire du GPU.
Utiliser l'API ROCm pour interroger les informations du périphérique, allouer et libérer de la mémoire sur le périphérique, copier des données entre l'hôte et le périphérique, lancer des kernels et synchroniser les threads.
Utiliser le langage HIP pour écrire des kernels qui s'exécutent sur le GPU et manipulent des données.
Utiliser les fonctions intégrées, les variables et les bibliothèques de HIP pour effectuer des tâches et opérations courantes.
Utiliser les espaces mémoire de ROCm et HIP, tels que global, partagé, constant et local, pour optimiser les transferts de données et les accès mémoire.
Utiliser les modèles d'exécution de ROCm et HIP pour contrôler les threads, les blocs et les grilles qui définissent le parallélisme.
Déboguer et tester les programmes ROCm et HIP à l'aide d'outils tels que ROCm Debugger et ROCm Profiler.
Optimiser les programmes ROCm et HIP en utilisant des techniques telles que la fusion des accès, la mise en cache, le préchargement et le profilage.
Cette formation en direct dans Ontario présente le kit d’outils CANN aux développeurs de frameworks IA. Apprenez à configurer des environnements, à convertir des modèles et à déployer des applications sur le matériel Ascend à l’aide de MindSpore, TensorFlow ou PyTorch, couvrant ainsi l’intégralité du flux de travail, de l’entraînement à l’inférence.
Optimisez les charges de travail IA sur Ascend, Biren et Cambricon grâce à cette formation pratique dans Ontario. Apprenez à effectuer des tests de référence des modèles, à identifier les goulets d’étranglement et à appliquer des optimisations au niveau du graphe, du noyau et de l’opérateur. Ajustez les pipelines de déploiement pour améliorer le débit et la latence sur ces plateformes de pointe.
Optimisez les performances d'inférence des réseaux de neurones sur les processeurs IA Ascend grâce à cette formation avancée en direct, animée par un instructeur, dans le cadre de Ontario. Explorez l'architecture d'exécution de CANN et profitez du moteur graphique (Graph Engine), de TIK et de TVM pour le profilage, le développement d'opérateurs personnalisés et la résolution des goulots d'étranglement de mémoire.
Migrer les applications CUDA vers des architectures GPU chinoises comme Huawei Ascend et Biren en Ontario. Ce cours dirigé par un instructeur guide les développeurs avancés dans la transposition du code et l'optimisation des performances, en couvrant des ateliers pratiques pour la transposition des bases de code CUDA vers de nouveaux SDK.
Cette formation en direct, animée par un formateur, en Ontario (en ligne ou sur site), s’adresse aux développeurs de niveau débutant à intermédiaire qui souhaitent utiliser CUDA pour programmer des GPU NVIDIA et exploiter leur parallélisme.
À l’issue de cette formation, les participants seront en mesure de :
Configurer un environnement de développement comprenant le CUDA Toolkit, un GPU NVIDIA et Visual Studio Code.
Créer un programme CUDA de base effectuant l’addition de vecteurs sur le GPU et récupérant les résultats de la mémoire du GPU.
Utiliser l’API CUDA pour interroger les informations de l’appareil, allouer et libérer la mémoire de l’appareil, copier les données entre l’hôte et l’appareil, lancer des noyaux et synchroniser les threads.
Utiliser le langage CUDA C/C++ pour écrire des noyaux exécutés sur le GPU et manipuler les données.
Utiliser les fonctions intégrées, les variables et les bibliothèques de CUDA pour effectuer des tâches et des opérations courantes.
Exploiter les espaces mémoire CUDA, tels que global, partagé, constant et local, pour optimiser les transferts de données et les accès mémoire.
Utiliser le modèle d’exécution CUDA pour contrôler les threads, les blocs et les grilles qui définissent le parallélisme.
Déboguer et tester les programmes CUDA à l’aide d’outils tels que CUDA-GDB, CUDA-MEMCHECK et NVIDIA Nsight.
Optimiser les programmes CUDA en utilisant des techniques telles que l’association (coalescing), la mise en cache, le préchargement (prefetching) et le profilage.
Cette formation en direct à Ontario guide les développeurs d'IA de niveau intermédiaire dans le déploiement de modèles sur des processeurs Ascend à l'aide du jeu d'outils CANN. Apprenez à convertir des cadres comme PyTorch et TensorFlow, à optimiser les performances et à déboguer les problèmes pour des scénarios d'inférence efficaces sur le bord du réseau et dans le nuage.
Cette formation en direct sur Ontario dote les développeurs des compétences nécessaires pour programmer et optimiser des applications sur les accélérateurs Biren AI. Les participants apprendront l'architecture des GPU, configureront le SDK et traduiront le code CUDA vers Biren. Elle se concentre sur les techniques d'ajustement des performances et de débogage.
Cette formation en direct animée par un formateur en Ontario équipe les développeurs des compétences nécessaires pour construire et déployer des modèles d'IA à l'aide de BANGPy et Neuware sur les MLU de Cambricon. Les participants configureront les environnements, développeront des modèles optimisés et intégreront l'accélération MLU dans des applications de périphérie et de centre de données.
Cette formation en direct, animée par un formateur à Ontario (en ligne ou sur site), s'adresse aux administrateurs système et professionnels de l'informatique de niveau débutant qui souhaitent installer, configurer, gérer et dépanner des environnements CUDA.
À la fin de cette formation, les participants seront en mesure de :
Comprendre l'architecture, les composants et les capacités de CUDA.
Installer et configurer des environnements CUDA.
Gérer et optimiser les ressources CUDA.
Débugger et dépanner les problèmes courants de CUDA.
Cette formation en direct, animée par un formateur en Ontario (en ligne ou sur place), s'adresse aux développeurs de niveau débutant à intermédiaire qui souhaitent utiliser OpenCL pour programmer des appareils hétérogènes et exploiter leur parallélisme.
À l'issue de cette formation, les participants seront capables de :
Configurer un environnement de développement incluant le SDK OpenCL, un appareil prenant en charge OpenCL et Visual Studio Code.
Créer un programme OpenCL de base effectuant une addition de vecteurs sur l'appareil et récupérant les résultats depuis la mémoire de l'appareil.
Utiliser l'API OpenCL pour interroger les informations de l'appareil, créer des contextes, des files de commandes, des tampons, des noyaux et des événements.
Utiliser le langage OpenCL C pour écrire des noyaux s'exécutant sur l'appareil et manipuler les données.
Utiliser les fonctions intégrées, les extensions et les bibliothèques OpenCL pour effectuer des tâches et des opérations courantes.
Utiliser les modèles mémoire de l'hôte et de l'appareil OpenCL pour optimiser les transferts de données et les accès mémoire.
Utiliser le modèle d'exécution OpenCL pour contrôler les éléments de travail, les groupes de travail et les plages ND.
Déboguer et tester les programmes OpenCL à l'aide d'outils tels que CodeXL, Intel VTune et NVIDIA Nsight.
Optimiser les programmes OpenCL à l'aide de techniques telles que la vectorisation, le déroulage de boucles, la mémoire locale et le profilage.
Cette formation en direct animée par un instructeur en Ontario (en ligne ou sur site) s'adresse aux développeurs C++ souhaitant utiliser CUDA pour accélérer des applications, écrire des noyaux GPU haute performance et tirer parti des bibliothèques d'algorithmes parallèles pour les charges de travail liées au calcul scientifique, au traitement des données et à l'apprentissage automatique.
Cette formation en direct, encadrée par un formateur à Ontario (en ligne ou sur site), s'adresse aux développeurs C/C++ souhaitant utiliser CUDA pour accélérer des applications intensives en calcul, notamment le traitement de données, les simulations scientifiques, les charges de travail d'apprentissage automatique et les pipelines de traitement d'image.
Cette formation en direct animée par un instructeur à Ontario (en ligne ou sur site) s'adresse aux développeurs de logiciels, aux analystes de données et aux professionnels techniques qui souhaitent utiliser TensorFlow 2.x et Keras pour construire, entraîner et déployer des modèles d'apprentissage en profondeur pour la vision par ordinateur, le traitement du langage naturel et les applications multimodales.
Ce cours de formation en présentiel dirigé par un instructeur en <lieu> couvre la programmation des GPU pour le calcul parallèle, l'utilisation de diverses plateformes, le travail avec la plateforme CUDA et ses fonctionnalités, ainsi que la réalisation de diverses techniques d'optimisation à l'aide de CUDA. Parmi les applications figurent l'apprentissage profond, l'analyse de données, le traitement d'image et les applications d'ingénierie.
En savoir plus...
Dernière Mise À Jour:
Nos clients témoignent (1)
L'énergie et l'humour des formateurs.
Tadeusz Kaluba - Nokia Solutions and Networks Sp. z o.o.
GPU formation à Ontario, Weekend Graphics Processing Unit cours à Ontario, Soir Graphics Processing Unit (GPU) formation à Ontario, Graphics Processing Unit formateur en ligne à Ontario, Graphics Processing Unit formation à Ontario, GPU cours du soir à Ontario, GPU formation Intra à Ontario, GPU (Graphics Processing Unit) formation Intra Entreprise à Ontario, Graphics Processing Unit formation Inter à Ontario, Graphics Processing Unit (GPU) formation Inter Entreprise à Ontario, GPU (Graphics Processing Unit) instructeur à Ontario, GPU coaching à Ontario, Weekend GPU formation à Ontario, GPU (Graphics Processing Unit) stage de préparation à Ontario, Graphics Processing Unit préparation à Ontario, Soir GPU cours à Ontario, Graphics Processing Unit entraînement à Ontario, GPU cours privé à Ontario, GPU formateur à Ontario, Graphics Processing Unit professeur à Ontario,Graphics Processing Unit (GPU) cours à Ontario, Graphics Processing Unit (GPU) cours particuliers à Ontario, GPU (Graphics Processing Unit) préparation aux examens à Ontario, GPU sur place à Ontario, Graphics Processing Unit (GPU) coach à Ontario